
Machbaseで半導体の生産データを管理・検索する
半導体の生産データには、製造装置に設置された多数のセンサーの値と、生産した製品の情報が混在しています。データ量は非常に大きく、収集周期によっては、ウェーハ1枚の生産情報だけで数GBに達することもあります。

従来は、上図のような生産データをXMLファイルにして、HadoopなどのNoSQL系ビッグデータ基盤へ保存・分析したり、XMLをRDBMSのBLOB列へ格納したりしていました。
個々のセンサーデータがウェーハのXMLファイル内に含まれるため、センサー値の時間的な変化を調べるのに適した形式ではありません。
데이터 처리의 문제
このように製品を中心にセンサーデータを記録する方法は、実際の運用でさまざまな課題を生みました。大量のセンサーデータ処理でよく見られる問題ですが、改めて整理します。
Hadoopでは、大量かつ高速に発生するデータの取り込みはできても、統計分析に必要なセンサーデータの読み出しに時間がかかり、この構成ではリアルタイム分析が困難でした。Sparkなどで検索を改善する方法もありますが、大規模なクラスターが必要となり、ハードウェア投資が膨らみます。
従来のRDBMSでは、必要な量を取り込む性能が不足していました。専用アプライアンスで改善できる場合もありますが、大きな投資が必要で、なお取り込み性能が十分ではないという課題がありました。
こうした課題を解決するため、時系列センサーデータに特化したMachbaseで検証を進めています。本稿では、高速な取り込みと顧客が求める検索を実現するためのデータベース構成を紹介します。
검색 대상 데이터 정의
Machbaseのタグテーブルは、センサー値を時刻とともに保存し、タグ識別子と時間範囲を指定して、膨大なデータを高速に検索できます。一方、生産情報、例えばその時点で処理していたウェーハやレシピをそのまま格納し、それを条件に検索する用途には性能上の制約があります。顧客が求める検索画面の例を次に示します。

この画面では、センサータグや時間範囲を直接指定する代わりに、センサーが属する装置のモジュールと、ロット番号またはウェーハ番号を選び、センサー値や統計を表示したいという要望があります。この検索を高速に行うには、入力時に生産データを少し変換する必要があります。
마크베이스 TAG 테이블을 위한 데이터 전처리
元の形式では、特定のウェーハやロットにセンサーデータが従属しています。Machbaseでは、センサーデータと工程データを分離して管理するほうが高い性能を得られるため、次のように変換します。
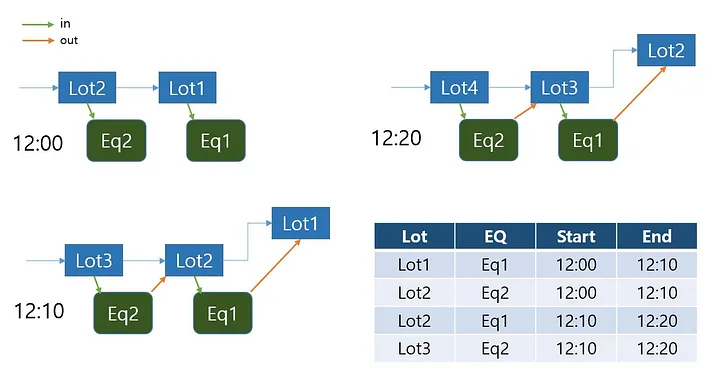
図のように、各ロットが加工のために装置へ入った時刻、出た時刻、ロット番号を記録します。Lot、eq、start、endを保存するこのテーブルを、工程データテーブル PROCESS_DATA とします。
センサーは各装置に取り付けられているため、装置を基にタグIDを検索できます。これはセンサータグのメタデータに相当します。ER図で表すと、次のようになります。

工場、ライン、装置、モジュール、センサータグという階層のER図です。
데이터 검색
装置ごとにタグIDを検索できるメタデータと、製品ごとの工程データがそろったので、3つのテーブルを結合することで、必要な結果を取得できます。

今回の検証では、100万タグ、総数100億件のデータから、特定の装置とロットに該当する90万件を検索し、0.1秒未満という結果を得ました。使用したのは4コア、32GBメモリ、SSDの環境です。また、検証範囲では総データ件数を増やしても、一定の検索性能を確認できました。
まとめ
半導体の生産データを扱う際の、従来のHadoop・RDBMS構成の課題と、時系列DBMSによる解決方法を紹介しました。Machbaseを活用するために、センサーデータと工程情報をどう分け、どのように検索するかを整理することで、高速な取り込み、検索、分析につなげられます。
半導体以外の産業でも、Machbaseの導入に役立つ技術や検証の進展があれば、今後の記事で紹介していきます。
ありがとうございました。
マークベースCTO シム・グァンフン


